即答AIとじっくり考えるAI、二刀流の時代へ
GPT-4oとo1系モデルがなぜ同じOpenAIの中で性格の違う二つの道具として併存するのか。推論時計算の仕組みから中小企業の使い分け戦略までを解説します。
AIが二人に分かれた。
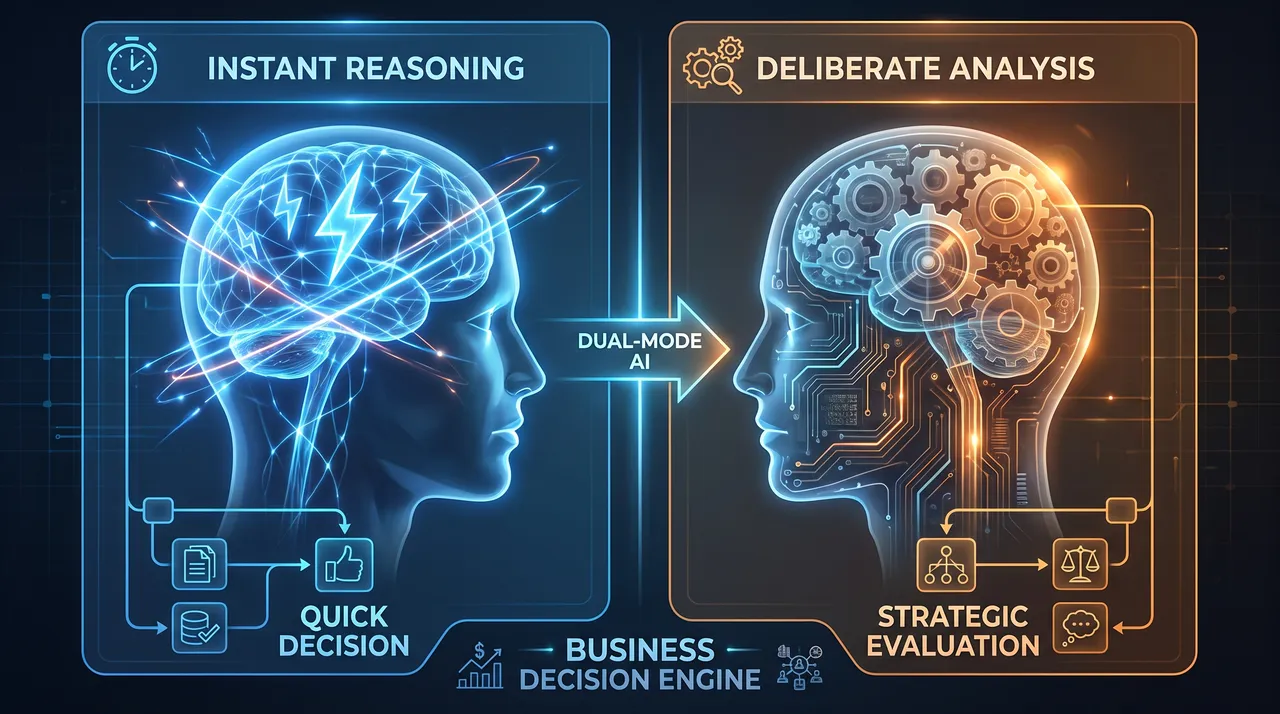
同じOpenAIの中で、即座に答えるAIと、考え込んでから答えるAIが、別人格として併存し始めました。反応速度を最優先するGPT-4oと、じっくり時間をかけて考え抜くo1系モデル(OpenAI公式解説)が、同じラインナップの中で性格の異なる道具として並んでいるのです。一つの万能なチャットボットに何でも聞けばいい、という前提は、静かに崩れつつあります。
一つのAIが、速さと深さに分かれ始めた
これまで生成AIは「一つのモデルが何でもこなす」ことを目指して進化してきました。質問の種類に関わらず、同じ頭脳が同じように答える。それが汎用性の証とされてきたわけです。
ところが現実には、GPT-4oのように反応速度を最優先し、チャット対応やコード補完のように「待たされるとストレスになる」場面に向いたモデルと、o1のように応答までに時間をかける代わりに、複雑な分析や多段階の論理展開を要する課題で強みを発揮するモデルとが、はっきり分かれて提供されるようになりました。
これは単なるラインナップ追加ではありません。AIが「一つの万能ツール」から「役割に応じて選ぶ道具」へと性格を変えつつある、という点に本質的な新しさがあります。本稿では、この分岐がなぜ起きているのかを技術的に掘り下げた上で、中小企業がどう向き合うべきかを展望します。
なぜ役割を分けざるを得なかったのか
疑問に思う方も多いでしょう。なぜ一つのモデルで速さも深さも両立できないのか、と。
理由は、速さと深さが根本的に異なる計算の使い方を要求するからです。OpenAIがo1系モデルで公表している「推論時計算(inference-time compute)」は、その違いを具体的に示しています(参考)。o1系は、質問に答える前に内部で複数の推論経路、つまり「考え方の筋道」をいくつも生成し、それぞれを評価してから最も妥当な結論を選び出します。試行回数を増やすほど誤った経路を捨てやすくなり、結果として精度が上がる仕組みです。裏を返せば、この試行錯誤の回数がそのまま応答時間とコストに跳ね返ります。
一方、即座に答えを返すGPT-4oは、この試行錯誤を切り詰め、浅い推論で結論を出すことに最適化されています。速さを取るか、試行回数を取るか——これは同じ計算資源の配分方法をめぐるトレードオフであり、「原理的に不可能」とまでは言えません。推論時計算のスケーリングやモデル蒸留といった技術は、このトレードオフを緩和する方向に進んでいます。ただし現状では、同一モデルで両方を最大化しようとすると、応答時間かコストのどちらかで妥協が生じやすいのが実情です。一つのモデルに両方を詰め込もうとすると、速さを求めるユーザーには「遅すぎる」と感じられ、深さを求めるユーザーには「浅すぎる」と感じられる、中途半端な妥協点に落ち着いてしまいます。GPT-4oとo1系が分かれて提供されているのは、この妥協を避け、それぞれの用途に最適化する道が選ばれた結果だと見ることができます。
言い換えれば、AIの進化は「一つの脳をより賢くする」方向から「複数の脳を適材適所で使い分ける」方向へと、軸足を移しつつあるのです。
速さ優先か、熟考優先か——仕事の割り振り方
この分岐は、実務への落とし込み方を考える上でも分かりやすい指針になります。
顧客対応のチャットボット、問い合わせメールの一次返信、議事録やメールのドラフト生成といった、スピードが価値を生む業務には高速応答型のモデルが向いています。待ち時間が数秒変わるだけで、顧客体験も社内の生産性も大きく変わるからです。
一方、経営判断に関わるデータ分析、契約書のリスク点検、複数の選択肢を比較した上での意思決定支援といった、誤りが許されず深い検討が求められる業務には熟考型のモデルを充てるべきです。多少時間がかかっても、浅い結論で経営判断を誤るリスクの方がはるかに高くつきます。
重要なのは、どちらが優れているかではなく、業務の性質に応じて使い分ける判断軸を持つことです。
実際、OpenAIの公式料金ページでは、推論特化のo1系モデルはGPT-4oよりも入出力トークンあたりの単価が高く設定されています。これは、先述した内部での試行錯誤に多くの計算資源を使う分が価格に反映されているためです。この価格差が今後さらに広がるかどうかは現時点では推測の域を出ませんが、用途に応じてモデルを使い分けることが、そのままコスト管理に直結する構造はすでにできあがっています。
中小企業が今から準備すべきこと
これから中小企業に求められるのは、「AIに何を聞くか」だけでなく「どちらの系統に聞くか」を設計する発想です。
具体的な手順はシンプルです。まず社内の業務を棚卸しし、前段で挙げたような基準でスピード優先の業務と精度優先の業務を仕分けます。次に、業務ごとに使うモデルを指定し、問い合わせ対応や定型文書作成には高速応答型、経営企画や財務分析、法務チェックには熟考型を割り当てます。最後に、必要な時だけ高コストな熟考型を使う運用ルールを整え、すべての業務を一律の設定で処理しないようにします。
この棚卸し→割当→運用ルール化という三段階が、今後のAI活用コストを最適化する鍵になります。一つのAIに万能を求める時代から、適材適所でAIを使い分ける時代へ。その変化に早く気づいた企業ほど、コストと精度の両立という果実を先に手にすることになります。